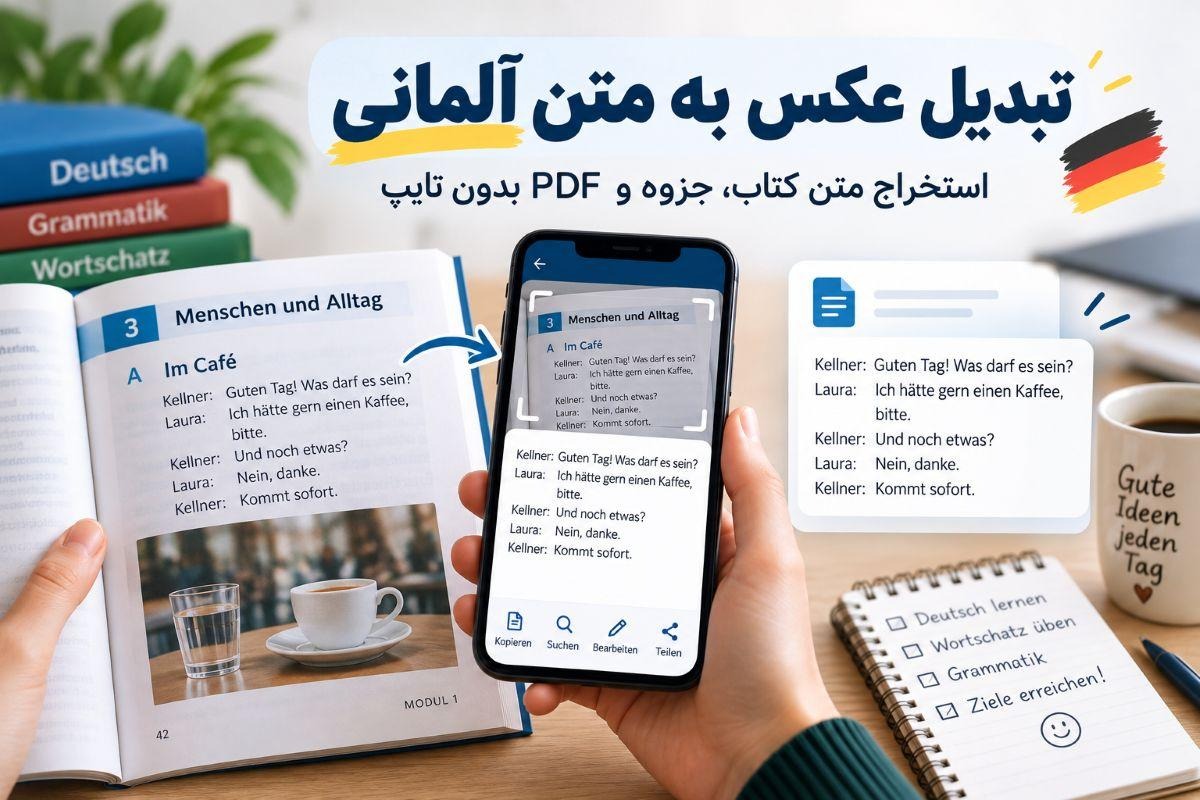


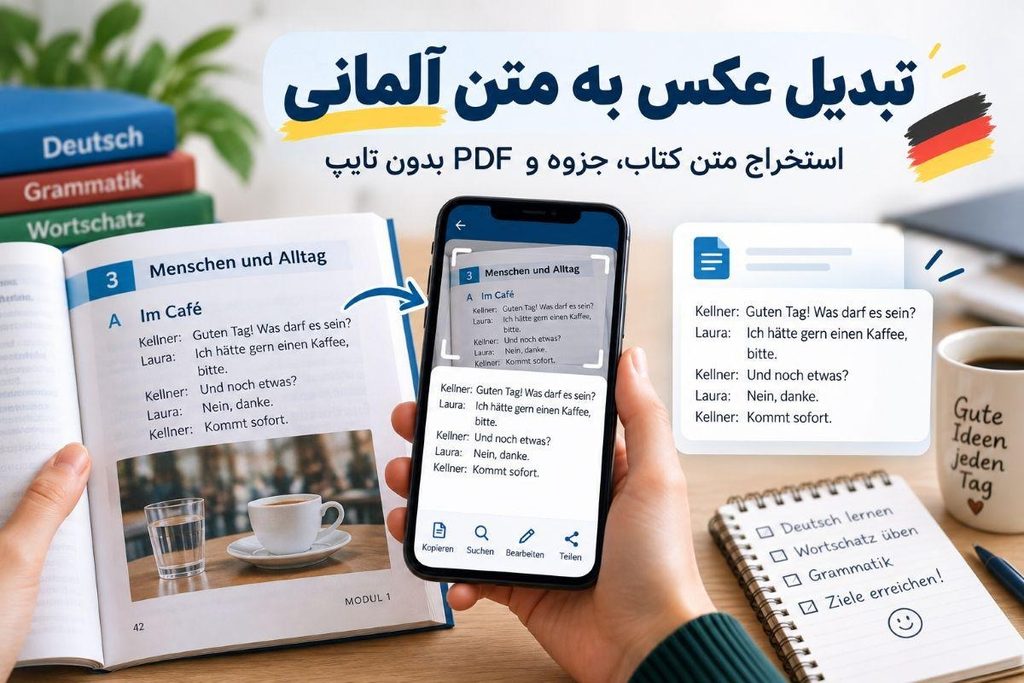
یک جمله آلمانی جلوی چشم شماست، اما نمیتوانید آن را کپی کنید! شاید صفحهای از کتاب Menschen باشد که با گوشی از آن عکس گرفتهاید، شاید هم مدرس، تصویری از تمرین کلاس برای شما فرستاده باشد یا PDF جزوهای را داشته باشید که انتخاب متن در آن کار نمیکند. حالا برای پیداکردن معنی یک واژه طولانی، بررسی جمله در دیکشنری یا ذخیره آن در جزوه شخصی، باید متن را دوباره تایپ کنید!
مشکل اینجاست که رایانه در چنین فایلهایی «متن» را نمیبیند؛ بلکه فقط تصویری از حروف را میبیند. اینجاست که تبدیل عکس به متن با کمک OCR کاربرد پیدا میکند و تصویر را به نوشتهای قابل انتخاب و کپی تبدیل میکند.
در این راهنما، مسیر استخراج متن آلمانی از عکس، کتاب، اسکرینشات و PDF را بررسی میکنیم و میبینیم چطور میتوان از خروجی برای یادگیری زبان استفاده کرد.
چرا متن آلمانی داخل عکس یا PDF قابل کپی نیست؟
ظاهر دو فایل PDF ممکن است کاملاً شبیه هم باشد، اما الزاما ساختار آنها یکسان نیست. درPDF متنی، حروف و کلمات بهصورت واقعی داخل فایل ذخیره شدهاند؛ بنابراین میتوانید یک واژه را انتخاب، کپی یا جستوجو کنید. اما در PDF اسکنشده، هر صفحه فقط تصویری از یک برگه است. در این حالت، کامپیوتر نوشته را بهعنوان متن مستقل نمیشناسد.
همین مسئله درباره عکس صفحه کتاب، اسکرینشات، برگه تمرین و جزوه اسکنشده هم صادق است. چیزی که شما بهوضوح بهصورت جمله میبینید، برای نرمافزار ممکن است فقط مجموعهای از پیکسلها باشد. اینجاست که تشخیص متن از تصویر یا OCR لازم میشود.
برای تشخیص این دو حالت، کافی است روی یکی از کلمات صفحه بکشید یا آن را انتخاب کنید. اگر بتوانید همان کلمه را جداگانه انتخاب و کپی کنید، فایل احتمالاً لایه متنی دارد. اما اگر کل صفحه مثل یک تصویر رفتار کند و هیچ کلمهای بهصورت مستقل انتخاب نشود، احتمالاً با یک PDF اسکنشده روبهرو هستید و برای استخراج نوشتههای آن به OCR نیاز دارید.
گاهی نیز یک PDF ترکیبی است؛ یعنی بعضی صفحهها متن واقعی دارند و بعضی دیگر بهصورت تصویر اسکن شدهاند. در این حالت بهتر است چند صفحه مختلف را بررسی کنید.
پس پیشاز تلاش برای کپی متن از عکس یا PDF، ابتدا مشخص کنید فایل واقعاً متنی است یا باید با OCR به متن قابل انتخاب تبدیل شود.
OCR چیست و چه تفاوتی با ترجمه عکس دارد؟
OCR یا تشخیص نوری نویسهها، فناوریای است که نوشته موجود در تصویر را شناسایی و به متن قابل ویرایش تبدیل میکند. نکته مهم این است که OCR معمولاً زبان جمله را تغییر نمیدهد؛ فقط نوشته را از داخل تصویر بیرون میآورد.
فرض کنید در عکس کتاب این جمله دیده میشود:
Ich lerne seit zwei Jahren Deutsch.
خروجی OCR هم همان جمله آلمانی است:
Ich lerne seit zwei Jahren Deutsch.
اما ترجمه عکس کار دیگری انجام میدهد و علاوهبر جداسازی متن، مفهوم جمله را به زبان مقصد تبدیل میکند:
«دو سال است که آلمانی یاد میگیرم.»
بنابراین تفاوت را میتوان ساده خلاصه کرد:
- OCR : تصویر ← متن
- ترجمه عکس: تصویر ← متن ←متن زبان دیگر
این تفاوت برای زبانآموز آلمانی مهم است. اگر فقط میخواهید نوشته داخل عکس یا PDF را به متن قابل کپی تبدیل کنید، OCR کافی است. بعد از استخراج متن، میتوانید همان جمله یا واژه را در دیکشنری جستوجو کنید، به فلشکارت اضافه کنید، ساختار گرامری آن را بررسی کنید یا در مرحله بعد آن را به فارسی ترجمه کنید.
به بیان ساده، OCR متن آلمانی را از تصویر بیرون میآورد؛ ترجمه، معنای همان متن را به زبان دیگری منتقل میکند.
حالا که تفاوت این دو مشخص شد، میتوانیم ببینیم استخراج متن آلمانی از عکس در عمل چگونه انجام میشود و برای عکس کتاب، اسکرینشات یا جزوه چه نکاتی اهمیت دارد.
چگونه متن آلمانی را از عکس، کتاب و اسکرینشات استخراج کنیم؟
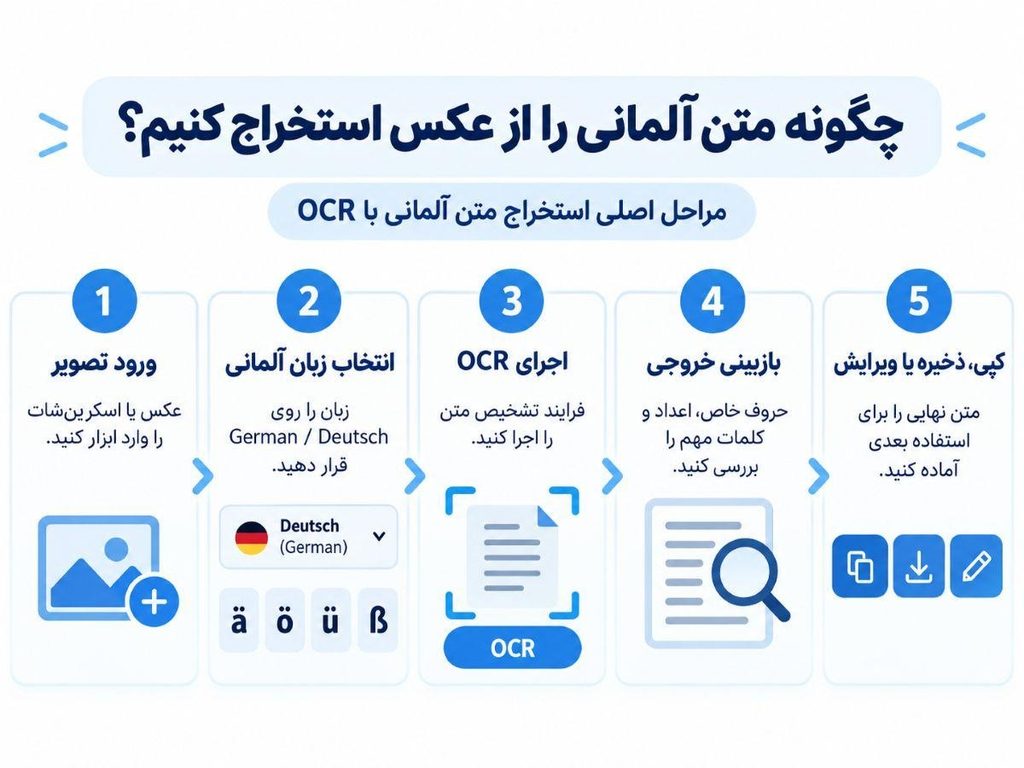
برای استخراج متن آلمانی از عکس، فرایند اصلی در بیشتر ابزارهای OCR تقریباً یکسان است و در چند مرحله انجام میشود:
۱. تصویر را وارد ابزار OCR کنید.
عکس میتواند صفحهای از کتاب، جزوه، تمرین کلاس یا یک اسکرینشات باشد. اگر فقط بخشی از تصویر برایتان مهم است، بهتر است همان قسمت را انتخاب کنید. سپس تصویر را وارد ابزار تبدیل عکس به متن کنید.
۲. زبان متن را روی German قرار دهید.
اگر ابزار امکان انتخاب زبان دارد، آلمانی را مشخص کنید. این کار به موتور OCR کمک میکند الگوی واژهها و نویسههایی مانند ä، ö، ü و ß را بهتر تشخیص دهد.
۳. فرایند OCR را اجرا کنید.
ابزار، تصویر را بررسی و نوشتههای موجود در آن را به متن قابل انتخاب تبدیل میکند.
۴. خروجی را با تصویر اصلی مقایسه کنید.
پیشاز استفاده، چند کلمه مهم، حروف خاص آلمانی، اعداد و نامها را کنترل کنید.
۵. متن را کپی، ذخیره یا ویرایش کنید.
حالا میتوانید متن استخراجشده را در دیکشنری جستوجو کنید، داخل جزوه خود قرار دهید یا در مراحل بعدی برای ترجمه و یادگیری زبان به کار ببرید.
استخراج متن از عکس صفحه کتاب
در صفحه کتاب، معمولاً با متن چاپی منظم روبهرو هستیم و OCR عملکرد مناسبی دارد. چالش اصلی زمانی ایجاد میشود که صفحه خمیده باشد، دو صفحه همزمان در تصویر دیده شوند یا نوشته به حاشیه کتاب نزدیک باشد.
استخراج متن از اسکرینشات
استخراج متن از اسکرینشات معمولاً سادهتر است، زیرا نوشته از ابتدا دیجیتال است و مشکلاتی مثل زاویه دوربین یا سایه وجود ندارد. کافی است تصویر را وارد OCR کنید و بخش مورد نیاز را استخراج کنید.
استخراج متن از جزوه و دستخط
تبدیل دستنویس آلمانی به متن دشوارتر از متن چاپی است و دقت آن به خوانایی دستخط و توانایی ابزار بستگی دارد. اگر متن چاپی و دستنویس در یک صفحه چاپی ترکیب شدهاند، بهتر است نتیجه هر بخش را جداگانه کنترل کنید.
چرا OCR در متن آلمانی اشتباه میکند؟
دقت OCR فقط به کیفیت ابزار بستگی ندارد؛ نوع نوشته و شکل صفحه هم میتوانند باعث خطا شوند. در متن آلمانی چند مورد بیشتر از بقیه نیاز به توجه دارند.
حروف ä، ö، ü و ß
Umlautها و حرف ß از حساسترین بخشهای متن آلمانی هستند. اگر تصویر تار یا فونت خیلی ریز باشد، ممکن است ü به u، ö به o یا ß به شکل دیگری تشخیص داده شود. این خطا گاهی خود کلمه را تغییر میدهد، بنابراین این حروف را بعد از OCR حتماً کنترل کنید.
شکست کلمات در پایان سطر
در کتابهای چاپی، واژههای بلند ممکن است در پایان خط شکسته شوند. برای نمونه:
Auf-
merksamkeit
OCR ممکن است این دو بخش را جدا نگه دارد یا خط تیره را جزئی از واژه بداند. به همین دلیل، کلمات مرکب و طولانی آلمانی باید با متن اصلی مقایسه شوند.
فونتهای قدیمی و Fraktur
در منابع قدیمی آلمانی ممکن است با Fraktur روبهرو شوید. شکل برخی حروف در این خط با فونتهای امروزی فرق دارد و موتورهای عمومی OCR همیشه آن را درست تشخیص نمیدهند. به همین دلیل، برای اسناد تاریخی مدلهای تخصصی OCR Fraktur نیز وجود دارد.
ساختار پیچیده صفحه
صفحههای دوستونه، متن کوچک، حاشیهنویسی، پسزمینه رنگی یا قرارگرفتن متن کنار تصویر میتوانند ترتیب خطوط و کلمات را بههم بزنند. در چنین صفحاتی، موتور OCR باید هم متن را تشخیص دهد و هم ساختار صفحه را حدس بزند.
کیفیت پایین تصویر یا دستخط
صفحه کج، نور نامناسب، سایه، تاری و فشردهسازی شدید تصویر، جزئیات حروف را از بین میبرند. دستخط نیز معمولاً از متن چاپی دشوارتر تشخیص داده میشود، مخصوصاً اگر حروف نامنظم باشند.
پس اگر خروجی OCR آلمانی خطا دارد، کیفیت منبع، فونت و چیدمان صفحه را هم بررسی کنید.
چگونه دقت استخراج متن آلمانی را بیشتر کنیم؟
بخش زیادی از خطاهای OCR را میتوان با آمادهسازی بهتر تصویر و یک بازبینی کوتاه کاهش داد.
قبل از: OCR
- دوربین را برای عکسبرداری موازی صفحه بگیرید: زاویه زیاد باعث کجشدن خطوط و خطای بیشتر میشود.
- نور یکنواخت داشته باشید: سایه دست، گوشی یا شیرازه کتاب نباید روی متن بیفتد.
- حاشیههای اضافی را Crop کنید: میز، انگشت، صفحه مقابل یا تصاویر غیرضروری، پردازش را سختتر میکنند.
- از تصویر واضح استفاده کنید: عکس تار یا فشرده، جزئیات ä، ö، ü و ß را از بین میبرد.
- زبان را روی German قرار دهید: اگر ابزار امکان انتخاب زبان دارد، این کار به تشخیص بهتر واژههای آلمانی کمک میکند.
- صفحات شلوغ را جدا کنید: در صفحههای چندستونه، هر بخش را جداگانه پردازش کنید.
بعد از OCR:
خروجی را مستقیم وارد جزوه یا فلشکارت نکنید. ابتدا این موارد را بررسی کنید:
- ä، ö، ü و ß
- کلمات مرکب و طولانی
- اعداد، تاریخها و نامهای خاص
- کلمات شکستهشده در پایان سطر
- ترتیب خطوط در صفحههای چندستونه
اگر قرار است چندین صفحه را پردازش کنید، ابتدا یک صفحه نمونه را امتحان کنید. اگر همان صفحه خطاهای زیادی دارد، پیشاز ادامه، کیفیت تصویر یا تنظیمات را اصلاح کنید. این کار از تکرار خطا در صفحات بعدی جلوگیری میکند.
بعد از استخراج متن آلمانی چه کارهایی میتوان انجام داد؟
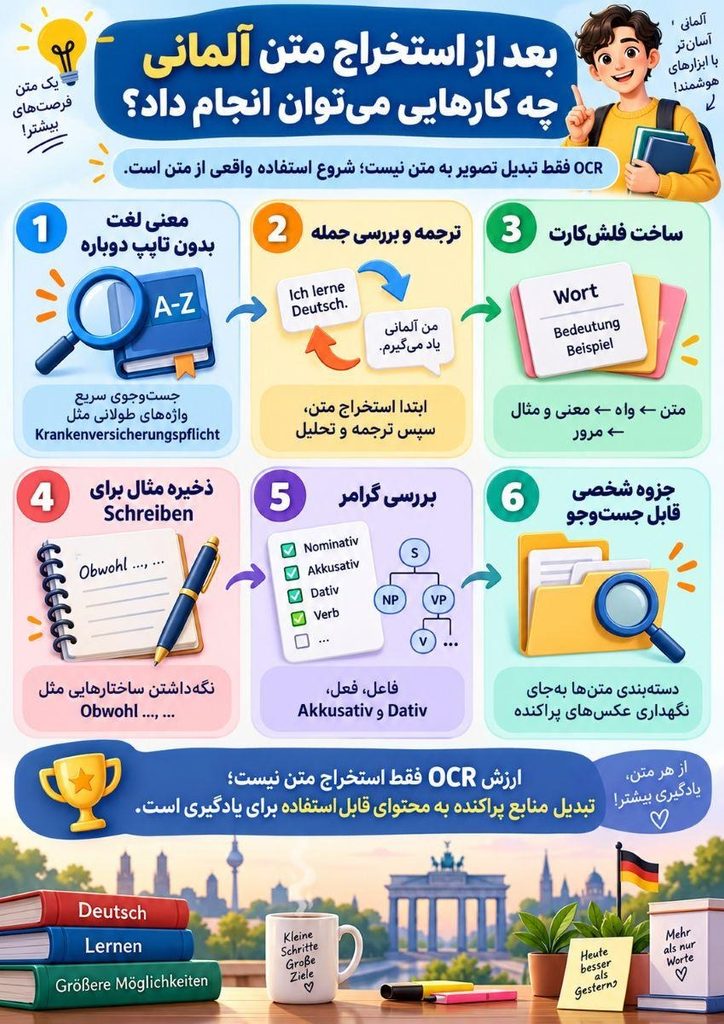
استخراج متن از تصویر، پایان کار نیست؛ بلکه معمولاً شروع مرحلهای است که متن در آن واقعاً کاربرد پیدا میکند. یک صفحه کتاب، جزوه کلاس یا تمرین آلمانی که قبلاً فقط بهصورت عکس در گوشی ذخیره شده بود، بعد از تبدیلشدن به متن میتواند در فرایندهای یادگیری زبان استفاده شود.
1.پیدا کردن معنی یک لغت بدون تایپ دوباره
یکی از کاربردهای مهم استخراج متن، بررسی سریع واژههای جدید است. در زبان آلمانی بسیاری از کلمات طولانی از ترکیب چند بخش ساخته میشوند و تایپ دوباره آنها، مخصوصاً از روی عکس کتاب، زمانبر است.
برای مثال، زبانآموزی که با واژهای مانند Krankenversicherungspflicht در کتاب روبهرو میشود، میتواند بعد از استخراج متن، آن را مستقیماً در دیکشنری جستوجو کند. همچنین میتواند ساختار کلمه را بررسی کرده و یا معنی دقیق آن را پیدا کند.
2.انتقال جملهها برای ترجمه و بررسی
OCR و ترجمه، دو مرحله متفاوت هستند. ابتدا باید متن اصلی آلمانی از تصویر استخراج شود و بعد، در صورت نیاز، ترجمه انجام شود.
داشتن متن واقعی این امکان را میدهد که جمله را در ابزارهای ترجمه، دیکشنریها یا منابع آموزشی دیگر بررسی کنید؛ بدون اینکه مجبور باشید هر جمله را دستی تایپ کنید.
3.تبدیل لغات جدید به فلشکارت
یکی از روشهای مؤثر یادگیری زبان، مرور واژهها در فاصلههای زمانی مشخص است. متن استخراجشده از کتاب یا جزوه میتواند بهعنوان منبع ساخت فلشکارت استفاده شود:
متن استخراجشده ← انتخاب واژه ← اضافهکردن معنی و مثال ← مرور
به این ترتیب، عکسهای پراکنده در گالری گوشی میتوانند به یک مجموعه منظم از واژهها و جملههای آموزشی تبدیل شوند.
4.ذخیره مثالهای مناسب برای Schreiben
برای زبانآموزانی که برای آزمونهای آلمانی آماده میشوند، جملههای آماده و ساختارهای نوشتاری ارزش زیادی دارند. یک جمله از کتاب یا تمرین میتواند بهعنوان نمونه برای یادگیری ساختارهای جدید ذخیره شود.
برای مثال، ساختارهایی مانند:
Obwohl …, …
یا جملههای دارای ترتیب خاص فعل، میتوانند بعداً برای تمرین Schreiben استفاده شوند.
5.بررسی ساختار گرامری جملهها
وقتی متن قابل انتخاب باشد، بررسی اجزای جمله سادهتر میشود. زبانآموز میتواند جایگاه فعل، حالتهای Akkusativ و Dativ، حروف اضافه و ساختار جمله را بررسی کند. انجام این کار روی یک تصویر ثابت دشوار است.
6.ساختن جزوه شخصی قابل جستوجو
بهجای نگهداری صدها عکس از صفحات کتاب و جزوه، میتوان متنهای مهم را استخراج، دستهبندی و ذخیره کرد. این کار باعث میشود پیداکردن یک واژه یا جمله در آینده سریعتر باشد.
در واقع، ارزش OCR فقط تبدیل تصویر به متن نیست؛ بلکه تبدیل منابع پراکنده یادگیری به اطلاعاتی است که میتوان دوباره از آنها استفاده کرد.
آیا OCR برای یادگیری زبان آلمانی جایگزین کتاب و مطالعه است؟
OCR قرار نیست جای کتاب، کلاس زبان یا مطالعه دقیق را بگیرد. یادگیری زبان فقط با داشتن متن اتفاق نمیافتد؛ فهم ساختار جمله، تمرین خواندن، گوشدادن، نوشتن و استفاده از واژهها همچنان به روشهای مختلف تمرین نیاز دارد.
نقش OCR بیشتر این است که فاصله بین دیدن یک متن و استفاده از آن را کمتر کند. برای مثال، وقتی زبانآموز در یک کتاب آلمانی به جملهای کاربردی، یک واژه جدید یا یک توضیح گرامری برخورد میکند، استخراج متن باعث میشود بتواند آن را راحتتر ذخیره، جستوجو و بررسی کند.
بهجای اینکه یک صفحه کتاب فقط بهصورت عکس در گالری گوشی باقی بماند، میتوان آن را به متنی تبدیل کرد که قابل دستهبندی و استفاده دوباره باشد.
بنابراین OCR بیشتر یک ابزار کمکی برای یادگیری است؛ ابزاری که زمان تایپکردن را کاهش میدهد و دسترسی به محتوای آموزشی را سادهتر میکند، اما جایگزین فرایند اصلی یادگیری زبان نمیشود.
OCR، Google Lens یا مترجم تصویری؛ کدام مناسبتر است؟
انتخاب ابزار به هدف کاربر بستگی دارد. OCR، مترجم تصویری و ابزارهایی مانند Google Lens الزاماً جایگزین کامل یکدیگر نیستند؛ بلکه هرکدام برای یک نیاز مشخص، مناسب محسوب میشوند.
| نیاز کاربر | ابزار مناسبتر |
| کپی چند خط از یک عکس | Google Lens یا ابزار OCR |
| استخراج حجم زیادی از متن کتاب یا جزوه | ابزار OCR |
| تبدیل PDF اسکنشده به متن | ابزار دارای OCR PDF |
| فهم سریع معنی یک تابلو یا جمله | مترجم تصویری |
| ذخیره متن برای استفاده بعدی | ابزار OCR |
| ساخت جزوه و فلشکارت از کتاب | ابزار OCR |
| بررسی گرامر و ساختار جمله | + OCR ابزارهای آموزشی |
اگر هدف فقط فهم سریع یک جمله یا تابلو باشد، مترجم تصویری میتواند کافی باشد. اما وقتی کاربر میخواهد متن آلمانی را استخراج کند، ذخیره کند، جستوجو کند یا در فرایند یادگیری دوباره استفاده کند، ابزار OCR کاربرد متفاوتی دارد.
Google Translate نیز امکان ترجمه متن داخل تصویر را ارائه میدهد و برای ترجمه سریع محتوای تصویری کاربرد دارد؛ اما استخراج ساختاریافته متن برای استفادههای بعدی، یک نیاز جداگانه است.
بنابراین انتخاب درست به پاسخ این سؤال بستگی دارد:
«آیا فقط میخواهم معنی یک تصویر را بفهمم، یا میخواهم متن داخل آن را داشته باشم و با آن کار کنم؟»
تفاوت OCR آنلاین و آفلاین چیست؟
ابزارهای OCR معمولاً به دو شکل کار میکنند: پردازش آنلاین یا پردازش آفلاین. تفاوت اصلی آنها به محل انجام پردازش و نیاز به اتصال اینترنت مربوط است.
در OCR آنلاین، تصویر یا فایل برای پردازش به سرور ارسال میشود و نتیجه پس از تحلیل دریافت میشود. این روش معمولاً برای پردازشهای سنگینتر یا زمانی که کاربر به قدرت پردازشی بیشتری نیاز دارد مناسب است، اما به اتصال اینترنت وابسته است.
در مقابل، OCR آفلاین بخشی از فرایند تشخیص متن را روی خود دستگاه انجام میدهد. این حالت میتواند در شرایطی که اینترنت در دسترس نیست یا کاربر نمیخواهد فایل خود را ارسال کند، کاربردی باشد.
انتخاب بین این دو روش به نیاز کاربر بستگی دارد. برای یک زبانآموز که گاهی در کلاس، سفر یا محیط بدون اینترنت از کتاب و جزوه عکس میگیرد، وجود گزینههای مختلف پردازش میتواند تجربه استفاده را سادهتر کند.
اسکنیفای؛ از عکس و PDF آلمانی تا متن قابل استفاده
تا اینجا دیدیم که استخراج متن فقط به معنی تبدیل یک تصویر به چند خط نوشته نیست. ارزش اصلی زمانی ایجاد میشود که متن استخراجشده بتواند وارد مرحله بعدی شود؛ مثلاً برای جستوجوی یک واژه در دیکشنری، ساخت فلشکارت، بررسی گرامر یا ذخیره در جزوه شخصی استفاده شود.
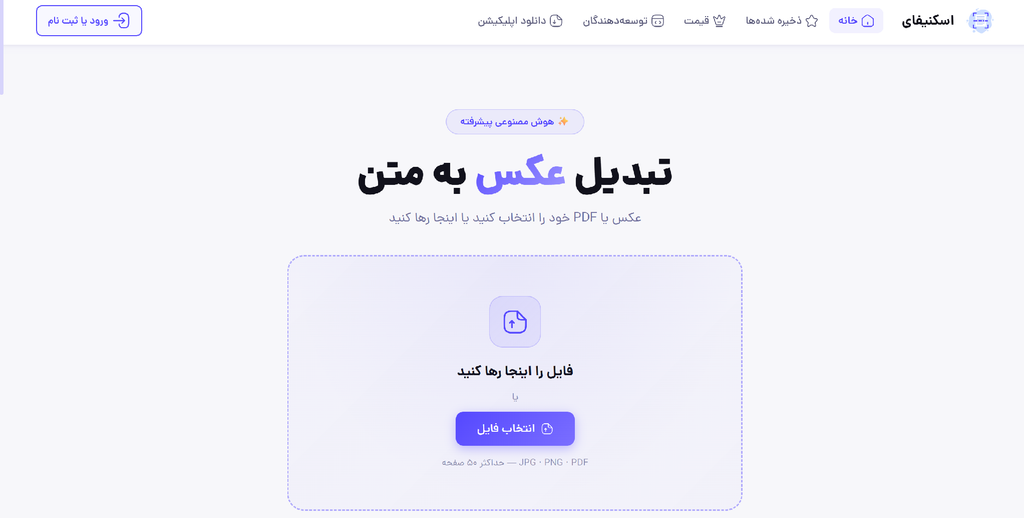
در چنین فرایندی، اسکنیفای میتواند بهعنوان یک ابزار استخراج متن از تصویر و PDF استفاده شود. سناریو ساده است؛ زبانآموز از صفحهای از کتاب آلمانی یا جزوه خود عکس میگیرد، فایل را وارد اسکنیفای میکند، متن استخراجشده را بررسی میکند و سپس آن را برای یادگیری یا دستهبندی اطلاعات به کار میبرد.
اسکنیفای امکان پردازش تصویر و PDF را دارد و از فرمتهایی مانند JPG و PNG پشتیبانی میکند. این ابزار با استفاده از موتورهای OCR میتواند نوشتههای داخل تصاویر را شناسایی کرده و خروجی متنی قابل استفاده ارائه دهد. همچنین امکان ذخیره، جستوجو و اشتراکگذاری متن استخراجشده از قابلیتهای این سرویس است.
برای زبانآموز آلمانی، مسیر زیر هنگام استفاده از این ابزار میتواند کاربردی باشد:
صفحه کتاب آلمانی ← اسکنیفای ← متن استخراجشده ← بررسی حروف ä، ö، ü و← ß استفاده در دیکشنری یا فلشکارت
یکی از نکات مهم درباره OCR این است که خروجی همیشه باید بررسی شود. حتی بهترین ابزارها هم در برابر تصویر تار، فونتهای خاص، صفحات قدیمی یا دستخط ناخوانا ممکن است اشتباه کنند. اسکنیفای نیز مانند هر ابزار OCR دیگری قرار نیست جای بازبینی انسانی را کاملاً بگیرد؛ هدف اصلی آن کاهش زمان تایپ و تبدیل سریعتر تصویر به متن قابل استفاده است.
در مورد دستخط نیز، تشخیص نوشتههای دستی به کیفیت و خوانایی دستخط وابسته است. هرچه نوشته واضحتر و منظمتر باشد، احتمال دریافت خروجی مناسب بیشتر خواهد بود.
چه زمانی نباید بدون بازبینی به OCR اعتماد کنیم؟
OCR، فرایند تایپ دوباره را کم میکند، اما به این معنی نیست که خروجی همیشه بدون بررسی قابل استفاده است. در بعضی محتواها حتی یک اشتباه کوچک میتواند مشکل ایجاد کند.
مواردی که بهتر است حتماً بررسی شوند:
- قراردادها و اسناد رسمی: یک کلمه یا عدد اشتباه ممکن است معنی سند را تغییر دهد.
- مدارک و شمارههای مهم: تاریخ، شماره پرونده، کدها و اطلاعات شناسایی باید با اصل فایل مقایسه شوند.
- نام اشخاص و مکانها: OCR ممکن است حروف خاص را اشتباه تشخیص دهد.
- متنهای آموزشی زبان: تغییر یک حرف در ä، ö، ü یا ß میتواند شکل واژه را تغییر دهد.
- دستخط یا فونتهای قدیمی مانند: Fraktur احتمال خطا بیشتر است.
بهترین روش این است که OCR را ابزاری برای سریعترکردن کار بدانیم، نه جایگزینی کامل برای کنترل نهایی.
سوالات رایج
آیا میتوان متن آلمانی را از عکس استخراج کرد؟
بله. با استفاده از ابزارهای OCR که از زبان آلمانی پشتیبانی میکنند، میتوان متن داخل عکس کتاب، جزوه یا اسکرینشات را استخراج کرد.
OCR حروف ä، ö، ü و ß را تشخیص میدهد؟
در تصاویر واضح معمولاً امکان تشخیص این حروف وجود دارد، اما بهتر است خروجی برای کلمات مهم بررسی شود.
چرا از PDF نمیتوانم متن را کپی کنم؟
اگر PDF اسکنشده باشد، صفحات آن مانند تصویر ذخیره شدهاند و متن واقعی داخل فایل وجود ندارد. در این حالت به OCR نیاز دارید.
OCR با ترجمه عکس آلمانی فرق دارد؟
بله. OCR نوشته داخل تصویر را به متن تبدیل میکند؛ اما ترجمه عکس، معنی همان متن را به زبان دیگری منتقل میکند.
جمعبندی
یک کتاب، جزوه یا PDF آلمانی نباید فقط بهصورت چند تصویر ذخیرهشده باقی بماند. وقتی تصویر به متن تبدیل میشود، امکان جستوجو، یادگیری، دستهبندی و استفاده دوباره از محتوا فراهم میشود.
اسکنیفای میتواند این مسیر را برای استخراج متن از عکس و PDF سادهتر کند؛ البته مانند هر ابزار OCR، بازبینی خروجی بخش مهمی از فرایند است.